La seguridad Zero-Trust aplicada a las APIs parte de un principio, ninguna petición debería considerarse fiable únicamente por proceder de una red interna, un sistema conocido o una ubicación determinada.
Cada acceso debe evaluarse según la identidad del usuario o workload, el recurso solicitado, la acción y el contexto.
En arquitecturas híbridas, esta verificación no puede depender siempre de un único gateway perimetral.
Un API Security Mesh permite extender este modelo distribuyendo el enforcement entre diferentes puntos de la arquitectura:
- API Gateways en el edge,
- proxies o ztunnels para tráfico east-west y,
- gateways inline delante de determinados sistemas legacy.
Estándares y tecnologías como SPIFFE/SPIRE, mTLS, Open Policy Agent, OpenTelemetry o DPoP pueden formar parte de ese modelo sin obligar a que toda la organización adopte un único stack.
En esta guía veremos:
- cómo aplicar seguridad Zero-Trust a una arquitectura de APIs sin fragmentar las integraciones existentes,
- cómo distribuir los controles entre cloud y legacy,
- cómo gestionar identidades de workloads y agentes de IA y,
- qué modelo de gobierno permite evitar nuevos puntos únicos de fallo o una dependencia excesiva de un proveedor.
¿Qué es la seguridad Zero-Trust aplicada a las APIs?
Zero Trust desplaza el foco desde el perímetro de red hacia los recursos, las identidades y las decisiones de acceso.
NIST SP 800-207 define precisamente Zero Trust como un enfoque en el que no existe confianza implícita únicamente por la ubicación física o de red de un usuario o activo.
La autenticación y la autorización deben producirse antes de establecer el acceso al recurso.
Aplicado a APIs, esto significa que estar “dentro de la red corporativa” no debería bastar para considerar una llamada segura.
Una petición debería poder responder, como mínimo, a preguntas como:
- ¿Quién está realizando la llamada?
- ¿Qué workload o aplicación está detrás?
- ¿En nombre de quién actúa?
- ¿A qué recurso quiere acceder?
- ¿Qué operación pretende ejecutar?
- ¿Qué nivel de riesgo tiene ese acceso en este momento?
El API Gateway sigue siendo una pieza importante para aplicar estos controles, pero deja de ser necesariamente el único punto desde el que se construye la confianza.
NIST SP 800-228, actualizado en marzo de 2026, organiza precisamente los riesgos y controles de protección de APIs entre fases de desarrollo, pre-runtime y runtime y recomienda una adopción incremental basada en riesgo.
Para profundizar en el enfoque general, consulta también las capacidades de Seguridad e Integración de la API de Chakray.
De un gateway centralizado a un API Security Mesh: ¿qué cambia?
Un API Gateway centralizado puede autenticar consumidores, validar tokens, aplicar rate limiting, transformar peticiones y proteger servicios backend.
Eso no significa que una arquitectura gateway-céntrica sea incorrecta ni que un gateway central sea automáticamente un Single Point of Failure (SPOF).
El problema aparece cuando todo el modelo de seguridad depende de un único punto de enforcement o cuando existe tráfico relevante que no atraviesa ese punto.
En una arquitectura enterprise pueden convivir:
- APIs públicas,
- microservicios que se comunican directamente,
- workloads Kubernetes,
- varias nubes,
- integraciones entre aplicaciones,
- agentes y automatizaciones M2M,
- ERPs y aplicaciones históricas,
- APIs legacy on-premise.
El gateway perimetral puede controlar muy bien el tráfico north-south, pero no necesariamente ve todas las comunicaciones east-west ni aquellas que se producen dentro de dominios legacy.
NIST SP 800-207A aborda precisamente este problema en arquitecturas cloud-native, híbridas y multicloud.
Su modelo contempla una combinación de API gateways, sidecar proxies e infraestructuras de identidad de aplicaciones como SPIFFE para aplicar políticas basadas en identidad independientemente de dónde esté desplegado el servicio.
Por eso, un API Security Mesh no debe entenderse como “sustituir el gateway por un mesh”.
La decisión correcta es distribuir el enforcement allí donde se produce realmente el acceso.
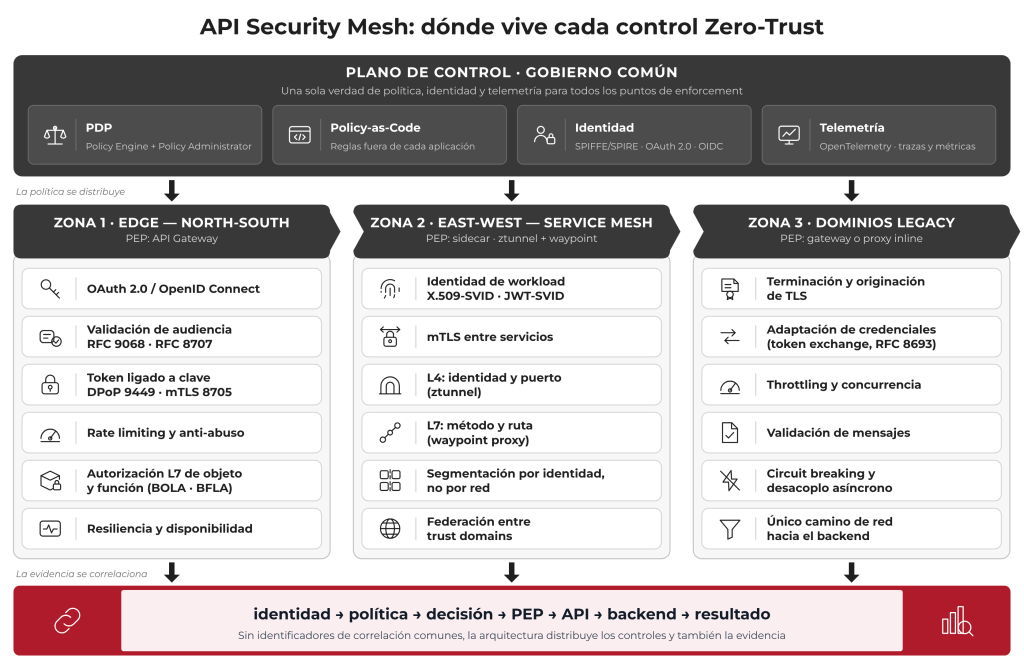
Cómo distribuir la seguridad Zero-Trust entre edge, service mesh y sistemas legacy
El objetivo es situar cada control cerca del tráfico que debe proteger manteniendo un gobierno común.
Edge: proteger el tráfico north-south
El API Gateway continúa siendo el punto natural de enforcement para:
- aplicaciones externas,
- partners,
- clientes,
- aplicaciones móviles,
- APIs públicas,
- determinados agentes y automatizaciones.
En esta capa pueden aplicarse mecanismos como OAuth 2.0, OpenID Connect, mTLS, validación de tokens, rate limiting, protección frente a abuso y controles específicos de cada API.
Para determinados escenarios OAuth también puede utilizarse DPoP (Demonstrating Proof of Possession), definido en RFC 9449.
DPoP permite vincular tokens OAuth 2.0 a una clave criptográfica controlada por el cliente, dificultando que un atacante que obtiene únicamente el token pueda reutilizarlo desde otro cliente.
Para tráfico servidor a servidor dentro del mesh, RFC 8705 permite vincular el token al certificado de cliente ya emitido, reutilizando el material criptográfico existente en lugar de introducir un segundo esquema de prueba de posesión.
East-west: la identidad del workload importa más que su red
En arquitecturas de microservicios, Kubernetes o multicloud, asumir que un servicio es fiable porque pertenece a una determinada subnet reproduce precisamente el modelo de confianza que Zero Trust intenta evitar.
Aquí pueden utilizarse mecanismos de workload identity y service mesh para autenticar servicios y proteger las comunicaciones east-west.
SPIFFE define un estándar para proporcionar identidad a workloads en entornos heterogéneos.
Mediante un SPIFFE Verifiable Identity Document (SVID), un workload puede demostrar criptográficamente su identidad, los X.509-SVID pueden utilizarse además para establecer canales TLS autenticados entre servicios.
mTLS y SPIFFE responden a quién llama, no responden a en nombre de quién ni sobre qué objeto.
Un canal perfectamente autenticado puede transportar una operación perfectamente no autorizada.
Sobre esa identidad pueden aplicarse políticas que respondan a preguntas como:
- ¿puede este servicio invocar este endpoint?
- ¿desde qué entorno?
- ¿para qué tenant?
- ¿con qué permisos?
- ¿sobre qué tipo de información?
El mecanismo concreto puede ser un sidecar tradicional o un modelo ambient. Conviene tener presente la diferencia: en ambient, el componente L4 (ztunnel) establece mTLS y autoriza por identidad, puerto y protocolo, pero las políticas de capa 7 (método, ruta o cabecera) requieren un waypoint proxy.
Una decisión del tipo «este servicio puede leer pedidos pero no modificarlos» es una decisión L7 y necesita un punto de enforcement que entienda la petición.
Zero Trust no exige una implementación concreta de service mesh.
Legacy: proteger sin convertir todo en cloud-native
Un ERP histórico, una aplicación industrial, un sistema SOAP o un mainframe pueden no admitir sidecars, rotación automática de certificados o cargas criptográficas adicionales.
La solución no debería ser forzar al sistema a adoptar capacidades para las que no fue diseñado.
En esos casos puede introducirse un gateway o proxy inline delante del dominio legacy.
Ese componente puede:
- terminar TLS,
- validar identidad,
- transformar credenciales,
- aplicar rate limiting,
- controlar concurrencia,
- validar mensajes,
- realizar circuit breaking,
- desacoplar determinadas operaciones mediante mecanismos asíncronos.
Un proxy inline solo aporta seguridad si es el único camino de red hacia el sistema protegido. Si el backend sigue siendo alcanzable directamente desde la red corporativa, el control es documental.
El enforcement distribuido exige, en cada capa, cerrar las rutas alternativas: segmentación, escucha restringida al proxy y denegación por defecto en el resto.
Te podría interesar: API wrappers en sistemas legacy para el control de costes de licenciamiento
Identidad Zero-Trust para workloads y agentes de IA
La proliferación de agentes, copilots y procesos automatizados multiplica el número de actores no humanos capaces de consumir APIs.
Una API key compartida o una cuenta técnica genérica deja de ser suficiente cuando diferentes agentes pueden consultar información, lanzar procesos o modificar sistemas corporativos.
La arquitectura debería separar al menos tres dimensiones: identidad del workload → autoridad delegada → acción solicitada
SPIFFE puede ayudar a demostrar qué workload realiza una conexión.
OAuth, OIDC u otros mecanismos de autorización pueden representar la autoridad concedida por un usuario o sistema.
Y la política debe decidir si esa identidad puede ejecutar esa operación concreta sobre ese recurso concreto en ese momento.
Por ejemplo, un agente autorizado para consultar el estado de una orden no debería obtener por extensión capacidad para modificar proveedores, cambiar datos bancarios o ejecutar un pago.
La unión entre ambas identidades se formaliza mediante intercambio de tokens (RFC 8693), el workload se autentica con su SVID y obtiene un token que incorpora, en el claim act, en nombre de quién actúa.
La autoridad resultante debe estrecharse de forma monótona (nunca ampliarse) respecto a la del usuario delegante.
Sin ese encadenamiento, un workload legítimo puede convertirse en diputado confundido, autenticado correctamente y ejecutando una acción que su delegante no podía ordenar.
La identidad tampoco debe permanecer indefinidamente activa. El ciclo de vida debería contemplar:
- alta,
- credenciales de corta duración,
- rotación,
- modificación de permisos,
- revocación,
- retirada.
Acortar la vida de las credenciales traslada el riesgo, la rotación y el desfase de reloj pasan a ser incidentes de disponibilidad, y conviene presupuestarlos antes de producción.
Sigue leyendo: Agentic Enterprise Architecture: cómo gobernar integraciones autónomas sin frenar la autonomía
Políticas Zero-Trust contextuales: gobernar de forma común, ejecutar cerca del tráfico
Una política basada únicamente en “token válido = acceso permitido” es insuficiente para una arquitectura Zero Trust compleja. Es el origen de API1 (BOLA) y API5 (BFLA) en el OWASP API Security Top 10 2023, decidir sobre qué objeto y qué función concretos no es lo mismo que validar un token.
La decisión puede depender simultáneamente de:
- identidad,
- tenant,
- acción,
- recurso,
- sensibilidad del dato,
- entorno,
- postura del workload,
- riesgo,
- comportamiento reciente,
- estado del backend.
Motores de Policy-as-Code, como Open Policy Agent, pueden ayudar a separar estas reglas de la lógica de cada aplicación.
Pero el patrón arquitectónico es más importante que la herramienta.
El riesgo aparece cuando cada API Gateway, equipo, sidecar o aplicación termina implementando su propia interpretación de la política corporativa.
Por eso conviene separar dos responsabilidades:
- Policy Decision Point (PDP): decide qué debería permitirse.
- Policy Enforcement Point (PEP): aplica esa decisión cerca del tráfico.
No todas las peticiones deberían tener que realizar una llamada remota al PDP.
Cuando existen varios PEP, la validación de destinatario deja de ser opcional. Un token emitido para una API no debería ser aceptado por otra:
- RFC 8707 permite acotar el recurso al solicitarlo y,
- RFC 9068 normaliza los claims que cada PEP debe verificar, para que múltiples puntos de enforcement no apliquen criterios distintos sobre el mismo token.
Dependiendo del riesgo, los PEP pueden:
- utilizar políticas distribuidas,
- caché controlada,
- TTL y,
- mecanismos de revocación
En todos los casos, deben permitir mantener el servicio durante interrupciones acotadas.
La estrategia de degradación debe definirse previamente. Esa estrategia debe fijar una antigüedad máxima de política por ruta y asumir que la revocación es lo primero que deja de funcionar cuando se cachea.
Una caída del plano de control no debería convertirse automáticamente en acceso ilimitado.
Shadow APIs: descubrirlas no es suficiente
Un modelo Zero Trust difícilmente puede proteger activos cuya existencia desconoce.
Las shadow APIs son especialmente problemáticas en organizaciones que han acumulado años de integraciones, adquisiciones, desarrollos departamentales y aplicaciones legacy.
Una API puede seguir operativa aunque no figure en el catálogo corporativo, no tenga owner claro o el equipo que la creó ya no exista.
El descubrimiento puede combinar fuentes como tráfico de red, gateways, repositorios, configuraciones cloud, service mesh, telemetría y observabilidad.
Ninguna fuente es completa por sí sola, y el punto ciego mayor es el tráfico east-west legacy: no aparece en el log de un gateway ni en un mesh en el que ese sistema no está.
Pero descubrir una API no equivale a gobernarla.
Cada activo localizado necesita una respuesta: ¿Quién es responsable? ¿Qué datos expone? ¿Quién la consume? ¿Debe mantenerse, securizarse, modernizarse o retirarse?
Ahí es donde API Security Mesh debe conectarse con API Governance: el mesh amplía dónde se puede observar y aplicar controles, y el gobierno define quién responde de lo descubierto y bajo qué reglas
No te pierdas nuestro artículo: Cómo controlar el API sprawl en entornos amplificados por inteligencia artificial
Cómo evitar nuevos puntos únicos de fallo
Distribuir PEPs no garantiza automáticamente que la arquitectura sea más resiliente.
Una organización puede pasar de un gateway central a veinte puntos de enforcement y seguir dependiendo de un único componente cuya caída paraliza todas las decisiones.
La clave está en separar correctamente control plane y data plane.
Los PEP deberían poder continuar aplicando políticas válidas durante interrupciones controladas del plano de decisión, con la redundancia adecuada y límites de blast radius definidos:
- políticas cacheadas cuando proceda,
- expiraciones definidas,
- mecanismos de revocación,
- comportamiento de degradación según riesgo,
El comportamiento debe variar según la criticidad.
Una operación financiera sensible puede requerir una postura fail-closed si no puede verificarse la autorización.
Una consulta de bajo riesgo podría admitir una política de degradación limitada y temporal, siempre que haya sido diseñada explícitamente.
No existe una regla universal.
La observabilidad también forma parte de la seguridad Zero-Trust
Cuando existen varios puntos de enforcement, el reto no es sólo aplicar la política, sino poder reconstruir qué ocurrió.
Una traza de seguridad útil debería poder correlacionar: identidad → política → decisión → PEP → API → backend → resultado
Si el edge registra una identidad, el mesh otra y el gateway legacy una tercera sin identificadores de correlación, la arquitectura habrá distribuido los controles pero también la evidencia.
Las capacidades de observabilidad permiten reunir logs, métricas y trazas de estos distintos componentes y detectar errores, denegaciones anómalas, latencia añadida o patrones de acceso inesperados.
Conoce nuestras capacidades de Observabilidad y API Monitoring
De desplegar herramientas a gobernar la transición
Uno de los principales riesgos de una iniciativa Zero Trust es sustituir una dependencia tecnológica por otra.
Por ejemplo:
- Antes: todas las políticas dependen del gateway.
- Después: todas las políticas dependen de una plataforma concreta de service mesh.
Técnicamente la arquitectura ha cambiado, pero organizativamente el problema puede seguir siendo el mismo.
Una transición enterprise necesita definir quién es responsable de cada capa, quién puede modificar políticas, cómo se priorizan sistemas, qué criterios debe cumplir una fase antes de avanzar y quién asume una excepción:
- qué documentación debe conservarse,
- cómo se transfiere conocimiento,
- cómo se cambia de proveedor si fuera necesario.
La respuesta técnica suele explicar qué componentes desplegar, pero no cómo gobernar la transición entre equipos, proveedores, legacy y dominios de seguridad.
| Dimensión | Enfoque táctico | Enfoque gobernado |
| Gateway → mesh | Desplegar proxies y políticas | Definir fases, responsables y criterios de salida |
| Identidad máquina | Emitir certificados o tokens | Gestionar lifecycle, ownership y revocación |
| Shadow APIs | Detectar endpoints | Asignar propietario y decidir remediación |
| Resiliencia | Añadir réplicas | Definir dependencias, degradación y blast radius |
| Auditoría | Guardar logs por componente | Correlacionar decisión y ejecución cross-layer |
| Vendor lock-in | Adoptar una plataforma | Diseñar portabilidad y estrategia de salida |
En Chakray planteamos estos proyectos desde el Gobierno y la Dirección: arquitectura, secuencia de migración, criterios de aceptación y ownership quedan documentados y no dependen del proveedor que ejecute cada fase.
Cómo implementar un API Security Mesh por fases
Una implantación de seguridad Zero-Trust no debería empezar desplegando simultáneamente nuevos gateways, service mesh, workload identity y Policy-as-Code en toda la organización.
El enfoque debería ser incremental y basado en riesgo, coherente con la estrategia que NIST SP 800-228 recomienda para la protección de APIs.
1. Descubrir el alcance real
Inventariar:
- APIs
- workloads
- consumidores.
- agentes,
- sistemas legacy,
- datos sensibles,
- rutas críticas,
- shadow APIs.
2. Establecer un modelo de identidad
Definir cómo se identifican:
- personas,
- aplicaciones,
- workloads,
- agentes,
- cuentas técnicas.
También deben definirse rotación, revocación y ownership.
3. Reforzar el edge
Revisar autenticación, autorización, validación, rate limiting, resiliencia y disponibilidad para el tráfico north-south.
4. Extender enforcement east-west
Empezar por los servicios con mayor riesgo o mayor necesidad de comunicación service-to-service controlada.
No es necesario incorporar todo el entorno al mesh al mismo tiempo.
5. Proteger los dominios legacy
Identificar qué sistemas requieren una capa inline y cuáles pueden mantenerse bajo controles existentes.
El objetivo es reducir riesgo sin desencadenar una modernización innecesaria.
6. Unificar políticas y evidencia
Normalizar:
- identidad,
- decisión,
- política,
- trazabilidad,
- correlación.
El objetivo es que varios PEP no se conviertan en varias verdades distintas.
7. Probar fallos y degradación
Simular:
- pérdida del PDP,
- pérdida de conectividad,
- expiración de políticas,
- caída de gateways,
- saturación,
- revocación de identidades.
La resiliencia Zero Trust debe probarse, no suponerse.
8. Formalizar el modelo operativo
Cerrar la transición con:
- runbooks,
- ownership,
- formación,
- documentación de arquitectura,
- procesos de cambio,
- criterios de salida de proveedor.
NIS2, DORA y PCI DSS: qué debe aportar la arquitectura
Un API Security Mesh no hace que una organización sea compliant automáticamente.
Lo que sí puede aportar es una base técnica más consistente para demostrar qué identidad accedió, bajo qué política, con qué decisión, dónde se ejecutó y sobre qué recurso.
En el caso de NIS2, el proceso de notificación para incidentes significativos contempla:
- una alerta temprana en un máximo de 24 horas,
- una notificación del incidente en un máximo de 72 horas y,
- un informe final, con carácter general, en el plazo de un mes desde la notificación.
Para las entidades financieras sujetas a DORA, el Reglamento Delegado (UE) 2025/301 establece que la notificación inicial de un incidente grave relacionado con las TIC debe enviarse lo antes posible y, en cualquier caso, dentro de las cuatro horas siguientes a su clasificación como incidente grave relacionado con las TIC y no más tarde de 24 horas desde que se tuvo conocimiento.
El informe intermedio debe enviarse, con carácter general, dentro de las 72 horas siguientes a la notificación inicial. Y el informe final debe presentarse en el plazo de un mes desde el informe anterior (o desde su última actualización)
PCI DSS plantea una exigencia distinta, el control de las identidades no humanas.
En su versión 4.0.1:
- el requisito 8.6.1 exige que cada acción de una cuenta de sistema o aplicación sea atribuible a un usuario individual,
- el requisito 8.6.2 prohíbe credenciales embebidas en scripts, ficheros de configuración o código,
- el requisito 8.6.3 obliga a rotarlas y protegerlas frente a uso indebido.
- el requisito 6.4.2 añade, en el edge, una solución técnica automatizada que detecte y prevenga ataques web delante de las aplicaciones públicas.
Es, punto por punto, el modelo de machine identity y el enforcement north-south descritos más arriba.
Esto no significa que DORA, NIS2 o PCI DSS prescriban una arquitectura API Security Mesh.
Significa que una arquitectura distribuida debe diseñarse para producir evidencia correlacionable si la organización quiere investigar y reportar incidentes con rapidez.
Los requisitos concretos de PCI DSS, DORA, NIS2 o cualquier otra regulación deberán mapearse según el sector, el alcance y los sistemas afectados.
Cómo reducir el vendor lock-in
Una arquitectura vendor-neutral no significa que todas las herramientas sean sustituibles sin coste.
Significa evitar que el modelo conceptual de seguridad dependa completamente de las primitivas propietarias de un único proveedor.
Algunos mecanismos pueden ayudar:
- SPIFFE para normalizar identidad de workloads,
- X.509 y mTLS como mecanismos interoperables de autenticación de transporte,
- OpenTelemetry para normalizar parte de la telemetría,
- Policy-as-Code para separar determinadas reglas de la lógica de aplicación.
Pero cambiar de service mesh, API Gateway o policy engine seguirá implicando trabajo.
Por ello, la estrategia de salida debe definir de antemano qué políticas son portables, qué configuraciones no lo son, cómo se exporta el inventario y qué pruebas validan equivalencia.
La exit strategy debe formar parte del diseño, no empezar cuando termina el contrato.
¿Cómo medir si la arquitectura está funcionando?
El éxito no debería medirse por el número de gateways, sidecars o políticas desplegadas.
Las métricas deben indicar si el riesgo disminuye sin deteriorar innecesariamente la operación.
Los indicadores relevantes son:
- latencia añadida por capa de enforcement, medida en p95 y p99 por salto,
- disponibilidad de PEP,
- tiempo de propagación de políticas,
- tasa de denegaciones por motivo,
- fallos de autenticación,
- fallos de rotación de identidad,
- APIs descubiertas sin owner,
- incidentes de autorización,
Una arquitectura con más controles pero menos comprensible puede ser más difícil de operar y auditar que la que pretendía sustituir.
¿Necesita toda organización un API Security Mesh?
No.
Si una organización dispone de pocas APIs, todas atraviesan una plataforma de API Management bien gobernada y no existe una complejidad importante east-west, multicloud o legacy, añadir service mesh y múltiples PEP puede introducir más coste que beneficio.
El patrón empieza a cobrar sentido cuando las fronteras reales de confianza dejan de coincidir con el perímetro del API Gateway, varios clouds, microservicios con tráfico directo, agentes de IA o APIs que no pasan por el edge.
Zero Trust no significa desplegar el mayor número posible de componentes.
Significa evitar que la confianza se conceda simplemente por estar dentro de la arquitectura.
Una transición hacia seguridad Zero-Trust distribuida afecta simultáneamente a API Management, identidad, integración, observabilidad, seguridad y arquitectura empresarial.
En Chakray podemos ayudarte a evaluar tu arquitectura actual, identificar gaps de seguridad, diseñar el modelo objetivo y dirigir una transición progresiva que preserve las integraciones existentes y reduzca la dependencia de decisiones tecnológicas difíciles de revertir. Habla con nuestros expertos y cuéntanos tu escenario.
Preguntas frecuentes sobre seguridad Zero-Trust y API Security Mesh
¿Qué es la seguridad Zero-Trust aplicada a APIs?
La seguridad Zero-Trust aplicada a APIs elimina la confianza implícita basada únicamente en la ubicación de red.
Cada acceso debe autenticarse y autorizarse teniendo en cuenta la identidad, el recurso, la operación y el contexto.
¿Qué es un API Security Mesh?
En este artículo utilizamos API Security Mesh para describir un patrón arquitectónico (no un estándar formal de NIST) en el que el enforcement de seguridad se distribuye entre diferentes puntos, como API Gateways, service mesh y gateways inline, manteniendo políticas, identidad y observabilidad gobernadas de forma común.
¿Un service mesh sustituye al API Gateway?
No. Normalmente son complementarios.
El API Gateway suele proteger tráfico north-south y consumidores externos, mientras que el service mesh puede aplicar identidad y políticas sobre tráfico east-west entre servicios.
¿Cómo aplicar Zero Trust a sistemas legacy?
Una opción es utilizar un gateway o proxy inline delante del sistema legacy para autenticar peticiones, adaptar identidad, limitar tráfico y aplicar políticas sin tener que modificar profundamente la aplicación original.
¿Cómo se identifican workloads y agentes de IA?
Los workloads pueden utilizar identidades criptográficas mediante estándares como SPIFFE/SPIRE.
Para agentes de IA también es necesario representar la autoridad delegada y limitar qué operaciones pueden ejecutar sobre cada recurso.
¿Cómo evitar vendor lock-in en un API Security Mesh?
Conviene separar identidad, política, telemetría y gobierno de la implementación concreta, utilizar estándares abiertos cuando resulten apropiados y documentar desde el inicio qué elementos son portables y cómo se realizaría un cambio de proveedor.