Token Economics en IA es el enfoque que permite medir y gobernar cuánto cuesta realmente utilizar modelos y agentes de inteligencia artificial.
En sistemas agénticos, para conocer el coste real de una tarea hay que sumar también las APIs y herramientas, los reintentos, los fallbacks y la infraestructura utilizada durante su ejecución.
Esta disciplina conecta token metering, FinOps para IA, AI Gateways, observabilidad y atribución de costes.
La FinOps Foundation define Token Economics como la práctica que relaciona el consumo de tokens con el coste y el valor generado por la IA.
Mientras, la Tokenomics Foundation, lanzada por Linux Foundation el 4 de agosto de 2026, trabaja en estándares abiertos y neutrales para medir el coste total, el valor y el ROI de la IA.
¿Qué es Token Economics en IA?
Token Economics estudia cómo se mide, atribuye, gobierna y relaciona con el valor empresarial el consumo de tokens generado por aplicaciones y sistemas de inteligencia artificial.
El token es la unidad básica con la que los modelos procesan información. Dependiendo del proveedor y del modelo pueden existir diferentes tipos de consumo:
-
- tokens de entrada,
- tokens de salida,
- tokens de entrada servidos desde caché (cached input tokens),
- tokens de razonamiento (reasoning tokens),
- consumo asociado a herramientas o capacidades adicionales.
Pero el concepto de Token Economics va más allá de calcular: número de tokens × precio por token.
En una aplicación sencilla, ese cálculo puede aproximarse bastante al coste de una interacción. En un sistema agéntico, no.
Un agente puede utilizar un modelo para razonar, consultar una base de datos vectorial, llamar a una API externa, volver a consultar el modelo, realizar varios intentos y finalmente ejecutar una acción sobre un sistema corporativo.
Conoce todas nuestras soluciones: Agentic Enterprise Architecture: cómo gobernar integraciones autónomas sin frenar la autonomía
Por todo ello, una práctica madura de Token Economics debe responder a dos preguntas diferentes:
- ¿Cuánto recurso de IA hemos consumido?
- ¿Qué resultado de negocio hemos obtenido con ese consumo y cuánto ha costado producirlo?
La propia FinOps Foundation plantea Token Economics como una extensión de FinOps hacia un nuevo tipo de consumo variable, la capacidad de inteligencia.
También advierte que una visión centrada únicamente en tokens deja fuera cómputo, almacenamiento, networking, bases vectoriales y otros costes que participan en una carga de IA.
Por qué el coste de los tokens no refleja el coste real de un agente
La factura del modelo representa solo una parte del coste de un workflow agéntico.
Imaginemos una empresa de pagos que utiliza agentes para automatizar el onboarding de nuevos clientes.
Una sola tarea puede recorrer esta secuencia: LLM → KYC → scoring → antifraude → LLM → core bancario
Cada capa genera consumo:
| Componente | Posible coste |
| Modelo LLM | Input, output, caché, reasoning |
| KYC | Consulta por operación o expediente |
| Antifraude | Llamada a API o servicio |
| Base vectorial | Almacenamiento y consultas |
| Gateway | Procesamiento y observabilidad |
| Cloud | CPU/GPU, almacenamiento, red y egress |
| Reintentos | Repetición de uno o varios pasos |
| Fallback | Ejecución con un modelo o servicio alternativo |
El proveedor del LLM conoce sus tokens. El proveedor KYC conoce sus llamadas. El cloud conoce CPU, GPU y tráfico.
Pero ninguno conoce necesariamente el coste de completar el onboarding. Y hay un efecto que la factura no muestra: el contexto acumulado se reenvía en cada paso, así que el coste de un workflow crece con el cuadrado del número de pasos, no de forma lineal.
Gartner prevé que el coste de inferencia por workflow agéntico aumente más de cinco veces hasta 2028, (septiembre de 2026) y lo llama la paradoja de la inferencia: el precio del token baja, pero el coste de la tarea sube porque incorpora más razonamiento, herramientas e iteraciones.
La dificultad ya es visible. En el estudio State of AI in FinOps 2026 de Harness (700 responsables de ingeniería en cinco países),
- solo el 20% identifica en horas el origen de un pico de coste y un 8% no lo consigue nunca,
- el 52% señaló que no existe un propietario claro del gasto de IA,
- y las organizaciones estimaron que aproximadamente el 26% de ese gasto se desperdicia.
El problema es que la unidad utilizada para medirla no coincide con la unidad que interesa al negocio.
¿Cómo configurar políticas de cuotas avanzadas y token metering para mapear tokens LLM y llamadas a APIs a nivel de tarea?
La clave es cambiar la unidad de atribución.
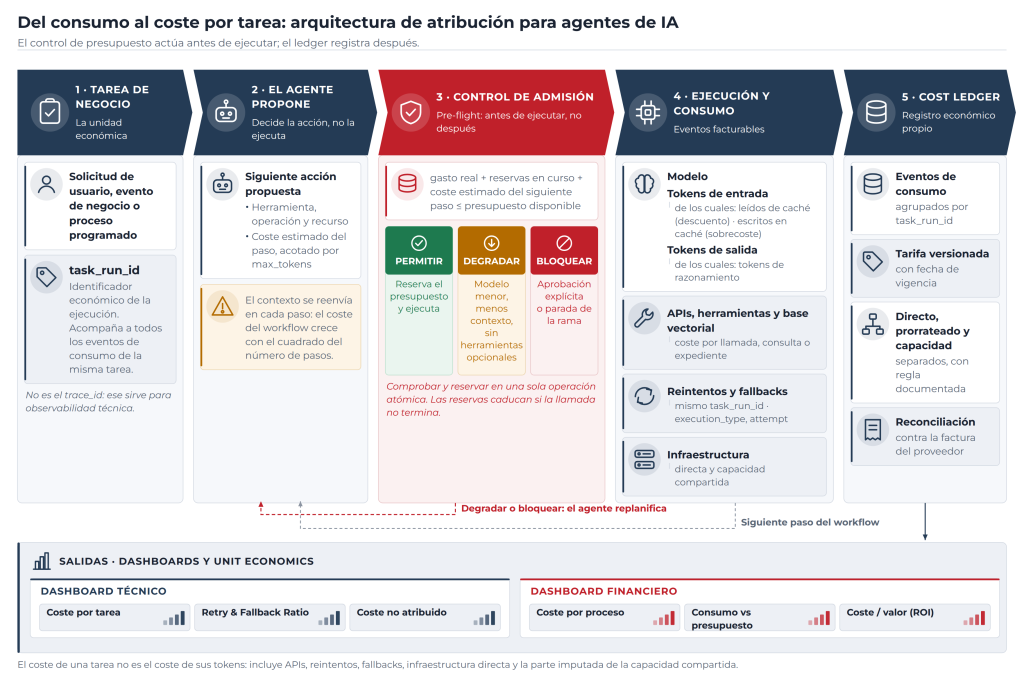
En lugar de medir únicamente coste por modelo, API o proveedor, cada ejecución debe tener un identificador común que acompañe a todas las operaciones que forman parte de la misma tarea.
Podemos denominarlo: task_run_id
La relación sería:
Proceso de negocio
↓
Workflow / agente
↓
task_run_id
│
├── LLM call
├── API KYC
├── API antifraude
├── consulta vector DB
├── retry
├── fallback de modelo
└── actualización sistema core
Gracias a ese identificador dejamos de preguntar: ¿Cuánto hemos gastado en el modelo X? y podemos empezar a preguntar: ¿Cuánto nos ha costado completar la tarea X?
Ese cambio parece pequeño, pero transforma completamente el modelo de gobierno.
task_run_id y trace_id no son exactamente lo mismo
- Un trace_id está diseñado principalmente para observabilidad técnica, reconstruir el recorrido de una petición entre componentes distribuidos.
- El task_run_id representa la unidad económica y de negocio sobre la que queremos consolidar el coste.
Pueden coincidir en determinadas arquitecturas, pero no deberían confundirse conceptualmente.
Un proceso de negocio puede necesitar varias trazas técnicas y seguir siendo una única tarea desde el punto de vista económico.
Qué datos debe registrar cada invocación
Para reconstruir el coste después, cada evento facturable debe conservar tanto contexto técnico como contexto de negocio.
Un esquema mínimo podría incluir:
| Dimensión | Campos orientativos |
| Tarea | task_run_id, trace_id |
| Agente | agent_id, workflow_id |
| Negocio | business_process, product, cost_center, tenant_id |
| Proveedor | provider, model, region |
| Recurso | LLM, API, tool, vector DB, GPU, gateway |
| Consumo | input, output, cached y reasoning tokens; requests; duración |
| Ejecución | primary, retry, fallback |
| Resultado | success, failure, partial |
| Precio | pricing_version, moneda |
| Coste | direct, shared o allocated |
En una invocación LLM podemos necesitar:
task_run_id
agent_id
provider
model
input_tokens
cached_input_tokens
reasoning_tokens
output_tokens
pricing_version
Este esquema permite construir un cost ledger, o registro económico, independiente de la consola de cada proveedor.
El principio es similar al que AWS recomienda para granularidad por petición, sus Application Inference Profiles permiten atribuir gasto agregado por aplicación o workload, pero AWS aclara que el coste por request requiere metadatos y logs de invocación adicionales. Bedrock admite metadatos por petición (hasta 16 pares clave-valor) para propagar el task_run_id, pero solo aparecen en los logs: la conciliación con la factura se hace uniendo logs y CUR por requestId.
Cómo calcular el coste real de una tarea agéntica
Una vez instrumentada la ejecución, el coste puede representarse mediante un modelo sencillo:
COSTE_TAREA =
COSTE_LLM
+ COSTE_APIS_Y_TOOLS
+ COSTE_RETRIES
+ COSTE_FALLBACKS
+ INFRAESTRUCTURA_DIRECTA
+ COSTE_COMPARTIDO_ASIGNADO
A su vez:
COSTE_LLM =
(input_tokens − cached_read) × tarifa_input
+ cached_read × tarifa_cache_read (descuento)
+ cached_write × tarifa_cache_write (sobrecoste)
+ output_tokens × tarifa_output (incluye los de razonamiento)
Los tokens en caché son un subconjunto de la entrada y los de razonamiento se facturan como salida: sumarlos aparte los cobra dos veces. No todas las plataformas facturan exactamente las mismas categorías ni del mismo modo, por lo que el modelo debe poder adaptarse a cada proveedor. Los descuentos por lote, la capacidad comprometida y los tramos por volumen rompen el precio por token y convierten parte del coste en coste de periodo.
Por eso las tarifas deberían almacenarse en una tabla de precios versionada, asociada a una fecha de vigencia.
Esto permite reconstruir correctamente una tarea histórica incluso cuando cambian el precio, el proveedor, el routing, el modelo o la modalidad de consumo, o entra un descuento contractual.
La versión de precio forma parte de la evidencia económica.
Cómo imputar reintentos y fallbacks
Un retry o un fallback no debería convertirse en una nueva tarea desde el punto de vista económico.
Si una consulta KYC falla tres veces antes de completarse, todos los intentos deben seguir vinculados al mismo task_run_id.
Podemos diferenciarlos mediante:
execution_type = retry
attempt = 2
parent_event_id = …
Lo mismo sucede cuando un agente empieza con un modelo y utiliza posteriormente otro como fallback.
El segundo modelo genera un nuevo evento de coste, pero pertenece a la misma tarea.
Esta distinción permite calcular métricas especialmente útiles:
- Retry Cost Ratio
coste_reintentos / coste_total_tarea
- Fallback Cost Ratio
coste_fallbacks / coste_total_tarea
Si un workflow empieza a aumentar sistemáticamente cualquiera de estas métricas, el problema puede no estar en el precio del modelo.
Puede estar en:
- prompts poco fiables,
- timeouts,
- integración con APIs externas,
- routing,
- selección del modelo,
- diseño del propio agente.
Aquí Token Economics además de ser una disciplina financiera se convierte también en una herramienta de diagnóstico arquitectónico.
Cómo repartir costes compartidos
No todos los costes pueden asociarse directamente a una tarea.
Una GPU reservada, un AI Gateway o una base vectorial pueden servir simultáneamente a cientos de procesos sin estar asociados directamente a una tarea.
La solución no es ignorarlos, sino establecer una regla explícita de reparto.
El orden debería ser:
- Atribución directa, cuando el consumo pueda asociarse técnicamente al task_run_id.
- Prorrateo por uso medible, por ejemplo tiempo, tokens, consultas o capacidad utilizada.
- Regla de distribución documentada, cuando no exista una señal más precisa.
Antes de prorratear conviene separar capacidad de consumo: una GPU reservada cuesta lo mismo con una tarea que con diez mil, y repartirla por uso hace que la misma tarea cueste más en un mes flojo.
Por ejemplo:
GPU compartida → tiempo de ejecución
Vector DB → número de consultas / volumen
Gateway → número de operaciones procesadas
Storage → volumen almacenado
La regla debe tener al menos: propietario + versión + criterio + fecha de vigencia.
Sin estas cuatro piezas, la distribución puede variar de un informe a otro y deja de ser defendible ante dirección financiera.
Presupuesto por agente: controlar el gasto antes de producirlo
Medir el gasto después es observabilidad, gobernarlo implica decidir antes de ejecutar si la siguiente acción cabe dentro del presupuesto disponible.
Una política puede combinar simultáneamente:
- coste,
- tokens,
- llamadas API,
- pasos,
- tiempo de ejecución.
Por ejemplo:
agent: onboarding-agent
budget:
max_cost_per_task: 0.60
currency: EUR
max_tokens: 150000
max_api_calls: 25
soft_limit:
at: 70%
actions: [alert_owner, forecast_overrun]
degrade:
at: 85%
actions: [use_lower_cost_model, reduce_output_budget, disable_optional_tools]
hard_limit:
at: 100%
actions:
– require_approval
– deny_next_action
Es un ejemplo agnóstico de fabricante.
La política podría utilizar un modelo de pre-flight budget reservation:
gasto_real
+ reservas_de_operaciones_en_curso
+ coste_estimado_siguiente_operacion
≤ presupuesto_disponible
El coste del siguiente paso se reserva contra max_tokens, que deja de ser un parámetro técnico para ser un control económico. Cuando la llamada termina, la reserva se sustituye por el consumo real, y caduca si la llamada nunca termina.
Esto resulta especialmente importante cuando varios agentes ejecutan acciones simultáneamente. Sin reservas, cada uno puede observar que todavía existe presupuesto y generar colectivamente un sobrepaso. La comprobación y la reserva deben ser una sola operación atómica.
Soft limit, degradación y hard limit
No todos los límites deben detener automáticamente una tarea. Podemos distinguir tres niveles:
Soft limit
La ejecución continúa, pero se genera una señal:
- alerta,
- previsión de sobrepaso,
- notificación al propietario.
Degradación controlada
Antes de bloquear, la arquitectura puede reducir el coste esperado:
- utilizar un modelo más económico,
- reducir contexto,
- reducir output,
- evitar una herramienta opcional,
- aprovechar caché,
- limitar nuevos pasos.
Hard limit
La siguiente acción no se ejecuta sin una excepción explícita. Puede:
- detener la tarea,
- requerir aprobación,
- cancelar una rama del workflow.
La decisión debería formar parte de la política empresarial y no estar dispersa por cada agente.
Token Economics y AI Gateway: qué papel tiene cada uno
El AI Gateway puede actuar como un punto de medición y enforcement, pero Token Economics es un modelo más amplio.
Un AI Gateway puede:
- medir tokens,
- aplicar rate limits y políticas,
- seleccionar modelos,
- registrar solicitudes.
Token Economics responde a otra pregunta: ¿Cómo relacionamos ese consumo con la tarea, su coste total y el valor que genera?
Por eso conviene no confundir una guía de AI Gateway con un modelo de Token Economics.
El gateway es una pieza de la arquitectura de control.
Token Economics define qué queremos medir, cómo lo atribuimos y con qué unidad económica evaluamos el resultado.
¿Quién debe gobernar el modelo de costes de IA?
No existe un único organigrama válido. Dependiendo de la organización, la responsabilidad puede residir en:
- FinOps,
- Platform Engineering,
- AI CoE,
- arquitectura,
- una función conjunta Tecnología-Finanzas.
Lo importante es que alguien tenga responsabilidad explícita sobre:
| Área | Responsabilidad |
| Esquema de atribución | Campos obligatorios |
| Tarifas | Actualización y versionado |
| Cuotas | Presupuestos y límites |
| Costes compartidos | Reglas de distribución |
| Excepciones | Aprobaciones |
| Reconciliación | Ledger vs. factura |
| Calidad | Coste no atribuido |
Sin esta propiedad, Token Economics corre el riesgo de convertirse en otro dashboard que nadie mantiene.
Del coste por token al coste por tarea
Aquí está el cambio más importante.
- Para el equipo técnico resulta útil conocer: Tokens consumidos: 120.000.
- Para FinOps: Coste del modelo: 0,18 €.
- Para el CFO: Coste de completar un onboarding: 0,52 €.
Son tres niveles de información distintos. Es el mismo onboarding: el modelo representa el 35% del coste de la tarea.
La última métrica permite empezar a construir unit economics reales. Algunos indicadores especialmente útiles serían:
| Métrica | Qué muestra |
| Coste por tarea completada | Coste unitario real |
| Coste p50/p95/p99 | Variabilidad |
| Coste por proceso | Impacto económico total |
| Retry Cost Ratio | Ineficiencia técnica |
| Fallback Cost Ratio | Dependencia de rutas alternativas |
| Coste no atribuido | Calidad de la instrumentación |
| Consumo frente a presupuesto | Riesgo |
| Coste / valor generado | Viabilidad económica |
Una tarea de 0,60€ que genera 20€ de valor puede ser económicamente mejor que otra de 0,15€ que no produce ningún resultado útil.
Por eso Token Economics debe conectar consumo y valor.
La propia FinOps Foundation define esta disciplina precisamente como la conexión entre consumo de tokens y resultados empresariales.
De Token Economics al ROI de un proceso de IA
Cuando el resultado puede expresarse económicamente, podemos pasar del coste al ROI:
ROI =
(valor generado – coste total del proceso)
/
coste total del proceso
El valor dependerá del caso:
- ingresos incrementales,
- reducción de coste operativo,
- menor tiempo de proceso,
- reducción de fraude,
- aumento de conversión,
- menor coste por expediente.
Ese dato debe proceder del negocio, no debe inventarse a partir del consumo técnico.
Por eso el task_run_id resulta tan importante: permite unir una ejecución técnica con un resultado empresarial.
La Tokenomics Foundation está trabajando precisamente para impulsar marcos y métricas neutrales que ayuden a relacionar el gasto de IA con su valor y retorno económico.
Cómo evitar el vendor lock-in en el modelo de costes
La organización debería utilizar las capacidades de atribución de cada proveedor, pero no permitir que sean el único lugar donde existe su modelo económico. La especificación abierta FOCUS existe precisamente para normalizar datos de coste entre proveedores.
El patrón sería: proveedor o cloud → telemetría nativa → normalización → task_run_id → cost ledger → showback, chargeback y ROI.
De este modo se pueden cambiar: modelos, proveedores, clouds, gateways o partners sin perder la forma de calcular cuánto cuesta una tarea.
Qué debería poder responder una organización antes de escalar sus agentes
Una arquitectura con Token Economics bien implantado debería poder contestar preguntas bastante concretas:
- ¿Cuánto cuesta completar cada tipo de tarea?
- ¿Qué porcentaje pertenece al LLM y qué porcentaje a APIs e infraestructura?
- ¿Cuánto estamos gastando en retries y fallbacks?
- ¿Qué agentes están superando su coste de referencia por tarea?
- ¿Qué tareas tienen mayor variabilidad de coste?
- ¿Cuánto gasto no podemos atribuir?
- ¿Podemos impedir una nueva operación antes de superar el presupuesto?
- ¿Qué valor de negocio genera cada proceso?
Si solo podemos responder: “Este mes utilizamos 400 millones de tokens”, todavía estamos midiendo consumo, no gobernando la economía de la IA.
En Chakray ayudamos a las organizaciones a abordar este problema desde la arquitectura de integración, API Management y gobierno de sistemas de IA, conectando el consumo del modelo con las APIs, herramientas y sistemas que realmente ejecutan cada proceso.
Si tu organización ya puede medir tokens pero todavía no puede explicar cuánto cuesta una tarea de extremo a extremo, podemos ayudarte a definir el modelo de atribución, instrumentar los puntos de control y convertir ese consumo en métricas de coste y valor que puedan utilizar tanto Tecnología como Finanzas.
Preguntas frecuentes sobre Token Economics
¿Qué es Token Economics en inteligencia artificial?
Token Economics es la disciplina que mide, atribuye y relaciona el consumo de tokens de los sistemas de IA con su coste y el valor empresarial generado.
En arquitecturas agénticas debe incluir también APIs, herramientas, reintentos e infraestructura que participan en la ejecución.
¿Cuál es la diferencia entre token metering y Token Economics?
El token metering mide cuántos tokens consume una aplicación.
Token Economics utiliza esos datos, junto con otros costes técnicos y de negocio, para calcular cuánto cuesta producir un resultado y evaluar si ese consumo genera suficiente valor.
¿Cómo se relaciona el coste de tokens con las APIs que llama un agente?
Propagando un identificador común como task_run_id por todas las operaciones del workflow.
Cada llamada LLM, API, retry o fallback registra su consumo bajo ese identificador, permitiendo reconstruir posteriormente el coste total de la tarea.
¿Cómo puede limitarse el presupuesto de un agente?
Mediante políticas que combinen coste máximo, tokens, llamadas API y otros límites.
Antes de cada acción puede reservarse el coste estimado y compararlo con el presupuesto restante para permitirla, degradarla, solicitar aprobación o bloquearla.
¿Qué es el coste por tarea completada?
Es la suma de todos los recursos necesarios para obtener un resultado de negocio: tokens LLM, herramientas, APIs downstream, reintentos, fallbacks, infraestructura directa y la parte correspondiente de los costes compartidos.
¿Token Economics sirve únicamente para reducir costes?
No. Su objetivo es relacionar coste y valor. Un workflow más caro puede ser mejor inversión si produce mayor ingreso, reduce más costes o mejora significativamente un proceso.
La métrica relevante no es consumir el menor número posible de tokens, sino obtener el mejor resultado económico por unidad de consumo.